CPU执行程序时,需要知道“当前函数的数据放在哪里”。RSP和RBP就是帮助CPU管理函数栈的两个指针。
RSP = Register Stack Pointer RBP = Base Pointer
RSP: 我现在栈顶在哪里? RBP: 这个函数的栈从哪里开始?
RSP 和 RBP 的距离,就是当前函数局部空间的大小(更准确说是栈帧中 RBP 以下部分的大小)。但是这个大小不是固定的。 RBP/RSP 是两个坐标 两个坐标之间的范围 = 栈帧的一部分
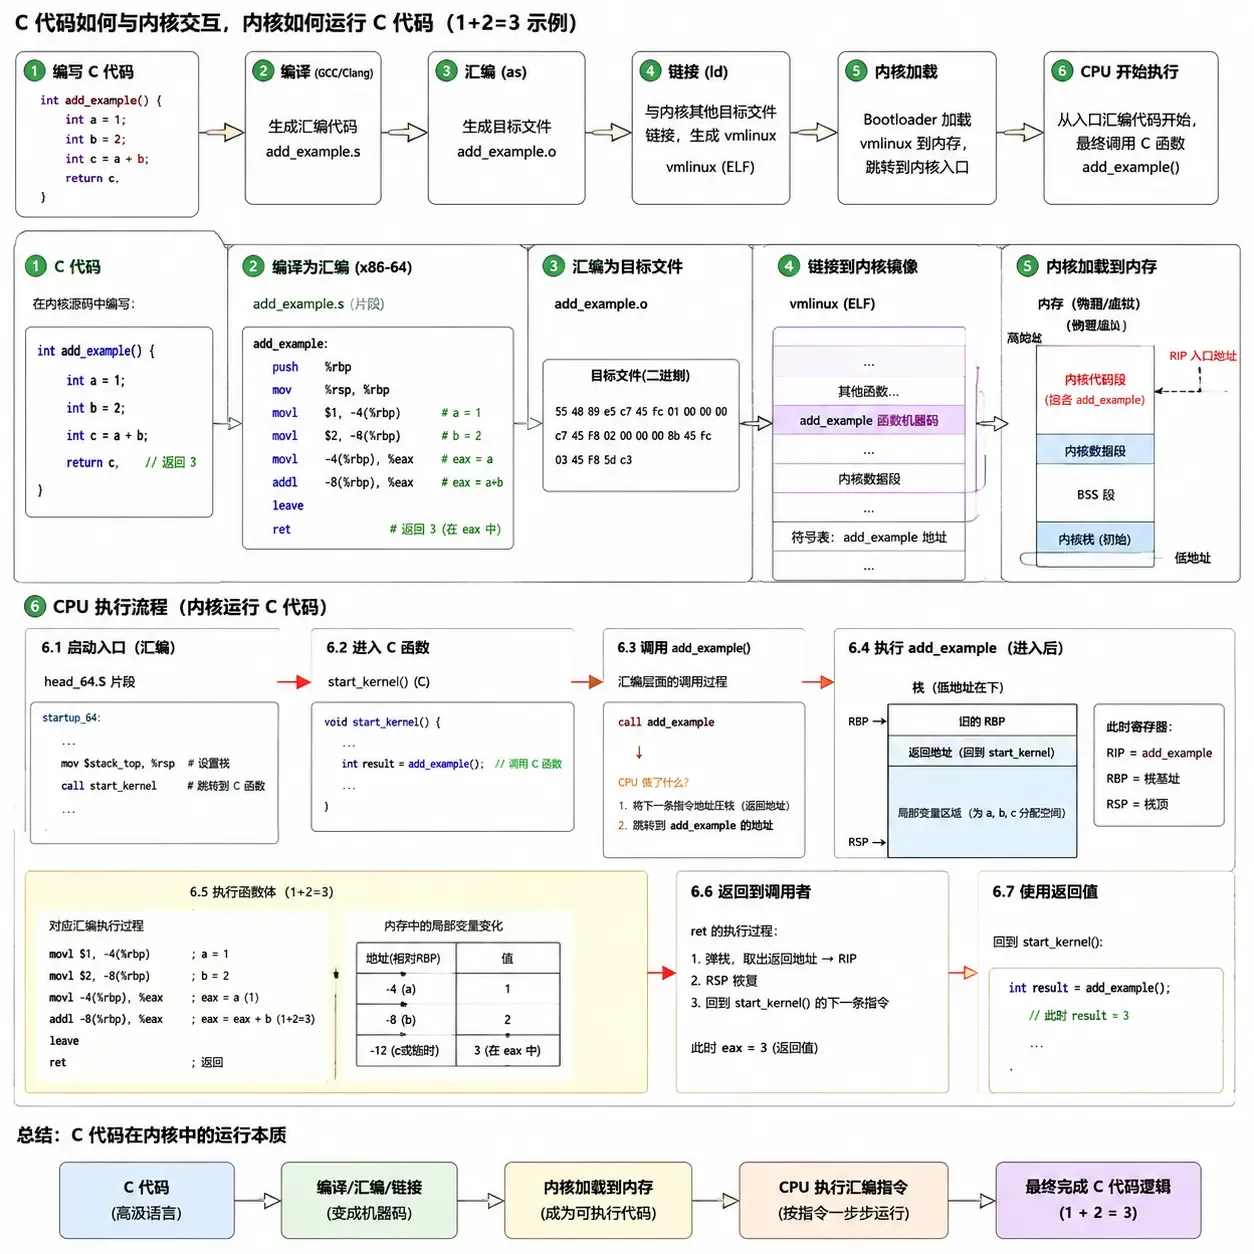
函数调用过程与栈
对,准确来说就是:先把返回地址保存(压入栈),然后跳转执行函数。
顺序非常重要。
比如:
main(){    func();
    printf("hello");}
假设:
1000: call func1005: printf("hello")CPU现在执行:
RIP = 1000第一步:执行 call func
CPU自动做两件事:
① 保存下一条指令地址
下一条是:
1005所以:
push 1005栈:
高地址
+-------------+| 1005        |  ← 返回地址+-------------+
低地址
RSP ↓
② 修改 RIP
原来:
RIP = 1000变成:
RIP = func地址于是CPU开始执行:
func()第二步:进入func
此时:
RIP ↓
func代码
但是栈里已经有:
+-------------+| 返回地址1005|+-------------+所以func知道:
我执行完以后,要回1005继续。
第三步:func建立自己的栈
比如:
void func(){ int a; int b;}编译器生成:
push rbpmov rbp,rspsub rsp,16变成:
          RBP           ↓
+----------------+| 旧rbp          |+----------------+| 返回地址1005   |+----------------+| a              |+----------------+| b              |+----------------+
          ↑         RSP
第四步:执行ret
函数结束:
retCPU做:
pop RIP也就是:
从栈取:
1005然后:
RIP = 1005继续执行:
printf("hello");所以完整链:
main
RIP=1000
执行 call func
        |        ↓
栈保存:返回地址1005
        |        ↓
RIP跳到func
func执行
        |        ↓
ret
        |        ↓
RIP恢复1005
继续main
你可以把 call 理解成:
“我要去别人家办事,但先把自己家的地址写纸条放门口,办完回来找纸条。”
这个“纸条”就是返回地址。
而为什么放栈?
因为函数调用可以无限嵌套:
main ↓func1 ↓func2 ↓func3每一层都有自己的返回地址:
栈:
func3 返回地址func2 返回地址func1 返回地址main 返回地址
刚好符合栈的 后进先出(LIFO)。
示例 func 调用过程
高地址------旧数据
新数据------低地址- 栈顶(RSP)永远在最下面
- 新函数、新变量从下面扩展
- RBP固定在函数入口附近,用来定位变量
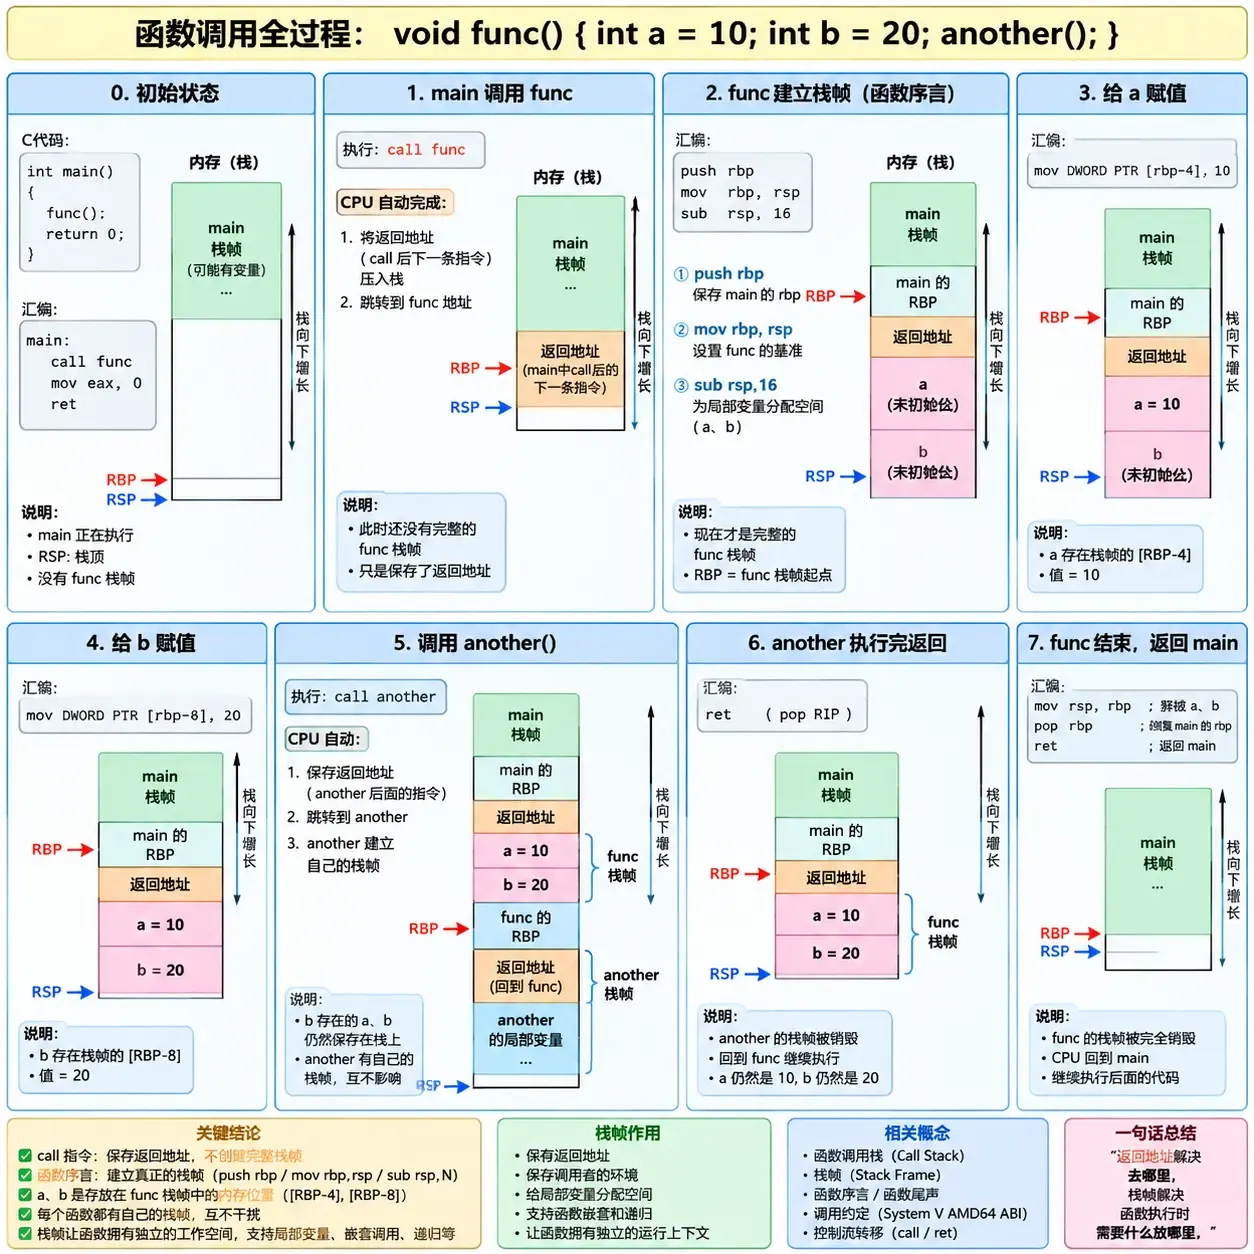
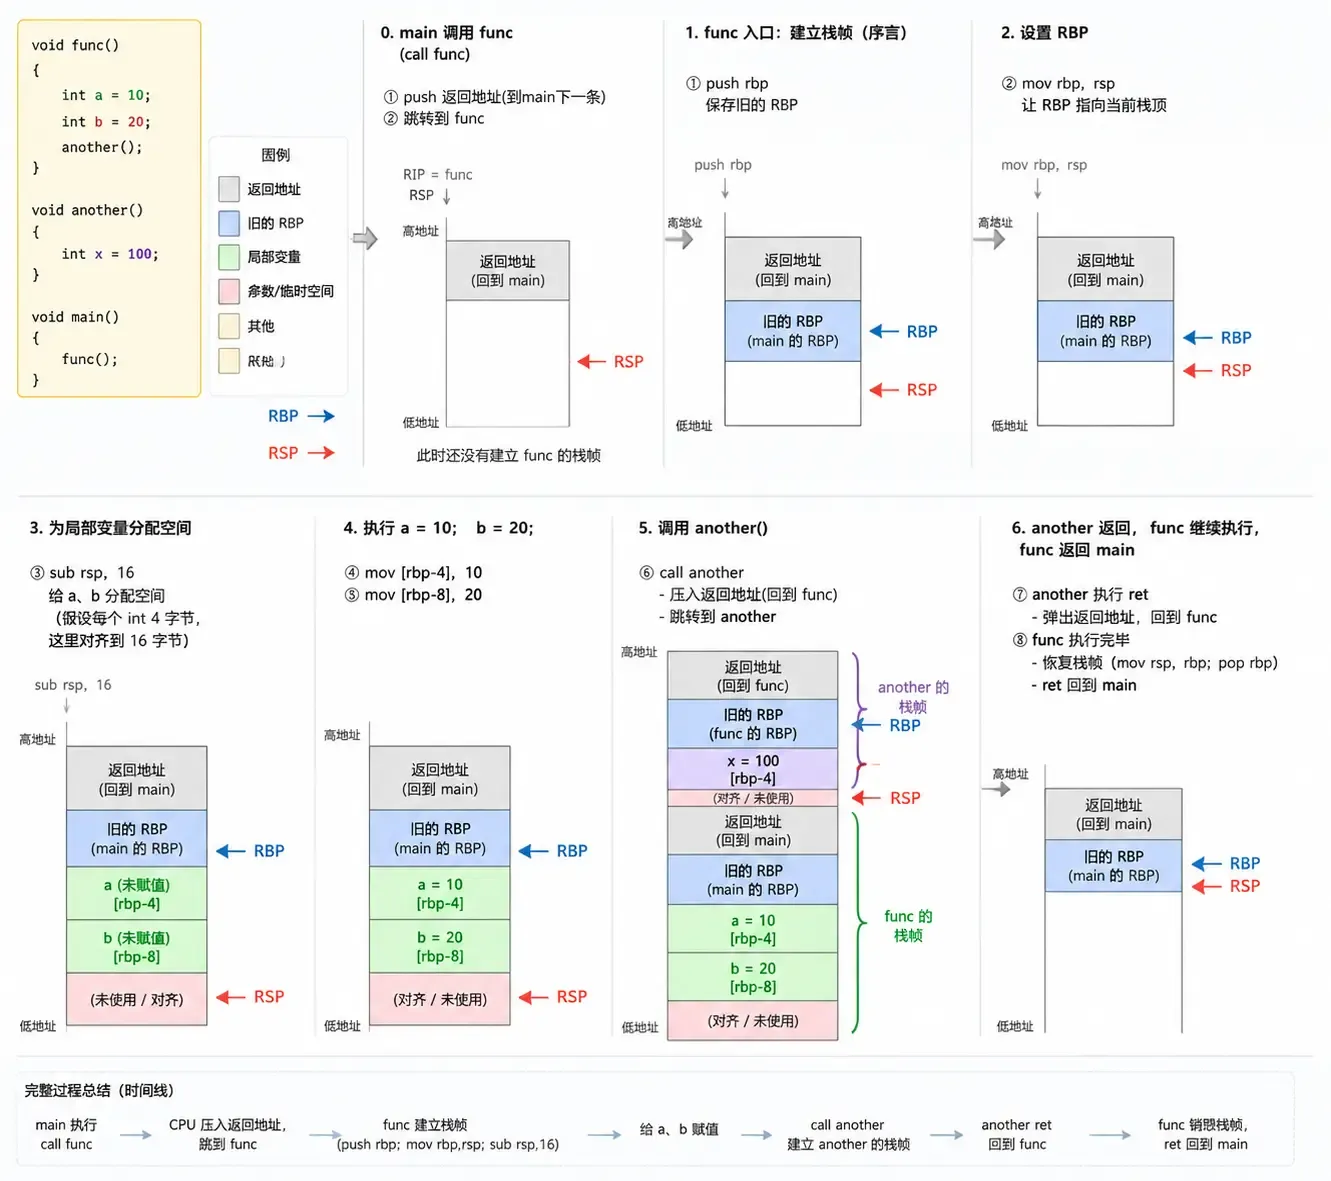
以RBP为基准点的计算
把 RBP 想象成你站在 10楼:
- 往下走 4 级台阶 → 到 9楼半(a 的家)
- 再往下走 4 级台阶 → 到 9楼(b 的家)
- 再往下走 8 级台阶 → 到 8楼半(空房间,没人住,但占了位置) RBP - N 就是“从基准点往下走 N 个字节”,不是减 4 次、减 8 次的意思。
地址值 内存内容 怎么算出来的───────────────────────────────────────────────── 1000 │ 保存的 main 的 RBP │ ← RBP 指向这里(基准点) 999 │ │ 998 │ │ 997 │ │───────────────────────────────────────────────── 996 │ 局部变量 a[0] │ ← RBP - 4 (1000 - 4 = 996) 995 │ 局部变量 a[1] │ 994 │ 局部变量 a[2] │ 993 │ 局部变量 a[3] │ a 是 int,占 4 个字节───────────────────────────────────────────────── 992 │ 局部变量 b[0] │ ← RBP - 8 (996 - 4 = 992) 991 │ 局部变量 b[1] │ 990 │ 局部变量 b[2] │ 989 │ 局部变量 b[3] │ b 也是 int,占 4 个字节───────────────────────────────────────────────── 988 │ 未使用填充 │ ← RBP - 12 (992 - 4 = 988) 987 │ 未使用填充 │ 986 │ 未使用填充 │ 985 │ 未使用填充 │───────────────────────────────────────────────── 984 │ 未使用填充 │ ← RBP - 16 (988 - 4 = 984) 983 │ 未使用填充 │ 982 │ 未使用填充 │ 981 │ 未使用填充 │───────────────────────────────────────────────── ↑ RSP 指向 984(最低地址)为何需要栈帧
这个问题是理解函数调用机制的核心。
一句话:
建立栈帧,是为了给这个函数创建一个“独立工作空间”,让它保存自己的数据,并且执行完后能恢复现场。
假设:
void func(){    int a;    int b;
    another();}
如果没有栈帧,会发生什么?
1. 函数需要自己的变量空间
比如:
void func(){ int a = 10; int b = 20;}运行时:
a在哪里?b在哪里?CPU不会自动知道。
所以需要:
func栈帧:
+-------------+| a = 10      |+-------------+| b = 20      |+-------------+
这就是局部变量存放的位置。
2. 函数调用函数,需要保存现场
看:
void func(){    int a;
    another();}
执行:
func | ↓another当 another 执行时,它也会使用寄存器:
比如:
RAXRBXRCX可能修改。
那么:
func 的数据怎么办?
所以需要保存:
func栈帧:
+----------------+| func的数据     |+----------------+| 保存的寄存器   |+----------------+| 返回地址       |+----------------+
another结束:
恢复回来。
3. 为什么不用全局变量?
可以想:
int a;int b;放全局。
但是:
函数可以同时存在很多次:
例如递归:
void func(){    int a;
    func();}
调用:
func() | func() | func()每一次的 a 都不同:
栈:
第三层func:a=3
第二层func:a=2
第一层func:a=1
所以必须每次创建新的空间。
4. 栈帧就是函数的一次“实例”
这个概念很重要:
代码:
func();只有一份。
但是运行时:
func第一次调用    ↓产生一个栈帧
func第二次调用    ↓产生另一个栈帧
类似:
类(class) ↓对象(object)代码是模板。
栈帧是运行中的实例。
5. RBP为什么参与?
建立栈帧:
push rbpmov rbp,rspsub rsp,16实际上是在说:
给func划一块地
这里是边界        ↓      RBP
下面这些空间给a、b使用
        ↓      RSP
之后:
访问:
mov eax,[rbp-4]就是:
拿func里的a6. 如果没有栈帧呢?
现代编译器其实可以:
mov [rsp+8],eax直接用 RSP。
所以:
不是CPU必须要栈帧。
而是:
-
C语言需要局部变量
-
函数需要独立空间
-
调用需要保存现场
于是形成了这种约定。
你可以这样理解整个过程:
main
call func | | CPU保存返回地址 ↓
func进入
建立栈帧 | | 给func分配私人工作区 | | 保存旧环境 | | 保存局部变量 ↓
func执行
 ↓
销毁栈帧
 ↓
ret返回main
所以:
返回地址解决“去哪儿”。
栈帧解决“函数执行时需要什么东西放哪里”。
两个是不同的问题。你前面疑惑“是不是已经有栈了”,其实就是把“返回地址”和“函数工作空间”混在了一起。
是否压栈?
如果调用函数后没有任何东西需要继续执行,理论上可以不用保存“返回地址”,但是要注意:普通函数调用的 call 指令仍然会压入返回地址。
原因是 CPU 的 call 指令设计就是:
call func固定行为:
-
保存下一条指令地址(返回地址)
-
跳转到 func
它不会检查后面有没有代码。
比如:
int main(){ func(); return 0;}汇编:
call funcmov eax,0ret有:
call func ↓保存 mov eax,0 的地址 ↓进入 func因为回来后还要执行:
mov eax,0但是如果:
int main(){ func();}最后就是调用 func。
编译器可能优化成:
jmp func而不是:
call func为什么?
因为:
call func逻辑:
保存返回地址跳过去func执行ret回来但是没有回来要执行的代码。
所以:
main ↓func ↓结束直接跳过去更省。
这叫:
尾调用优化(Tail Call Optimization)
例如:
void main(){ return func();}编译器可能:
原本:
call funcret优化:
jmp func不过有一个特殊点:
即使没有 C 代码,函数也可能需要返回。
比如:
void A(){ B();}如果 A 是被 main 调用的:
main | A | BB 执行完要回 A:
B ret → AA 执行完要回 main:
A ret → main所以返回地址仍然存在。
总结:
| 情况 | 是否需要保存返回地址 |
|---|---|
普通函数调用 call |
需要 |
| 调用后还有代码执行 | 需要 |
| 尾调用优化 | 可能不用,改成jmp |
| 函数最后一条语句调用另一个函数 | 编译器可能优化 |
所以你的理解可以修正成:
不是因为“后面有没有代码”决定是否压栈,而是使用
call就一定压入返回地址;如果编译器确定不需要返回,才可能不用 call。